结论前置:数据岗位的核心产出是“可执行的建议”
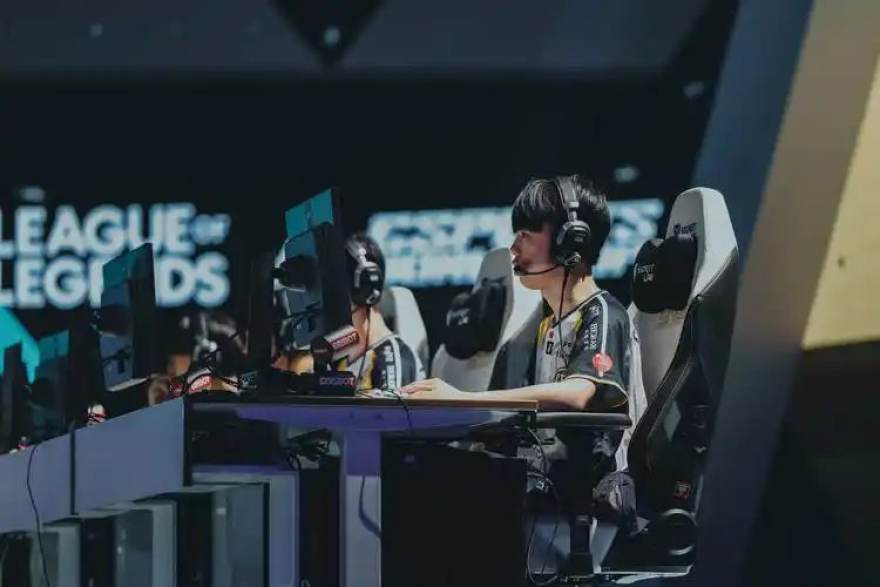
在S16总决赛的备战体系里,数据分析师不是“跑表格的人”,而是把公开赛事数据翻译成教练组能直接使用的决策建议。以程砚舟所在战队的工作流为例,一名分析师在赛段推进中的主要产出包括版本优先级清单、对手习惯模型和赛前简报三部分。本文按公开访谈与赛事公开信息整理这条工作流,并对S16总决赛的版本解读方法做出观察。S16总决赛的对抗强度意味着,任何一条建议都必须能被训练赛验证,否则就只是纸面结论。
文中涉及的具体训练安排与内部流程为示例性描述,用于说明岗位分工,不代表任何战队的官方信息。
上午:版本优先级清单怎么来
程砚舟的一天从版本清单开始。S16总决赛使用的版本在赛段内保持稳定,但各赛区对同一版本的理解存在差异,分析师的工作是把这些差异量化。他会先整理公开赛事中的英雄出场率与胜负关系,再按位置拆分成“高优先级”“条件选择”“陷阱选项”三档,最后交给教练组讨论。
- 数据来源:公开赛事记录、官方版本说明、战队公开采访中的BP表述。
- 处理方法:按赛区分组对比,避免把单一赛区的习惯当成全局结论。
- 输出形式:一页纸的优先级清单,每条结论附一到两条公开赛事依据。
这一步的关键不是数据量,而是结论的可验证性。S16总决赛的BP节奏快,清单如果太长,教练组在有限时间里用不上,因此分析师会主动压缩条目,只保留能在训练赛中复现的判断。
下午:对手建模与训练赛复盘
下午的时间主要花在对手建模上。程砚舟会把对手近期的公开比赛按“前期节奏”“资源交换”“团战站位”三个维度切片,形成习惯模型。例如对手辅助在多少分钟开始第一次游走、打野在失去第一条小龙后的路径偏好、以及队伍在落后经济时的抱团频率。
这些模型不直接给出胜负预测,而是用于训练赛的针对性设置。教练组会根据模型设计三到五套开局方案,训练赛结束后再由分析师核对模型与实战的偏差。偏差大的部分会被标记,进入下一轮修正。S16总决赛的赛程密度高,这套流程的周转速度直接决定备战质量。
- 模型维度:前期游走节点、资源交换偏好、逆风局抱团频率。
- 验证方式:训练赛复盘对照,偏差项进入下一轮修正。
- 协作对象:教练组、选手代表、体能与管理团队。
晚间:赛前简报与信息降噪
晚间的工作是写赛前简报。简报的读者是选手,因此篇幅被严格限制:每名选手只看到与自己位置相关的一页内容,包含对手习惯、可选英雄、以及两条需要注意的时间节点。程砚舟的说法是,简报的目标是“让选手在五分钟内读完并记住”,而不是展示分析深度。
信息降噪是这一步的重点。S16总决赛期间公开讨论量大,分析师需要筛掉无法验证的说法,只保留有公开赛事依据的结论。这也是本站整理赛事资讯时遵循的原则:结论前置、来源可查,帮助读者在赛段推进中快速掌握关键信息。本站客户端安卓与苹果 iOS 端提供赛程与战队资料查阅入口,内容均按公开信息整理。
观察:数据岗位的边界在哪里
把程砚舟的工作流放回S16总决赛的语境,可以看到数据岗位的边界相当清晰:分析师提供依据,教练组做决定,选手执行。三者之间任何一环缺位,数据都无法转化成赛场表现。对读者来说,理解这条边界有助于更理性地看待赛后的数据讨论——一场比赛的胜负很少由单一数据指标决定,更多是决策链条整体运转的结果。
人物故事的意义也在这里。S16总决赛的聚光灯通常打在选手身上,而分析师这类幕后岗位的日常工作,恰恰构成了赛事内容的另一层纹理。记录这些流程,不是为了神化某个岗位,而是让观众知道一场比赛背后有多少可被检验的准备工作。
一页纸清单这个细节很真实,建议太多教练根本用不上,压缩条目才是功力。
对手建模那段讲得清楚,切片维度选得合理,比空谈数据有用。
赛前简报给选手看一页这个做法挺聪明的,信息过载确实会拖慢决策。
分析师的边界说得好,提供依据和做决定是两回事,赛后讨论经常混在一起。
幕后岗位的流程写得不夸张,读完对备战周期有了具体概念。